Le RAG permet à un modèle de langage de répondre à partir de documents ou bases de connaissances propres à l’organisation, plutôt que de se limiter à ce qu’il a appris pendant son entraînement.
La chaîne RAG en pratique
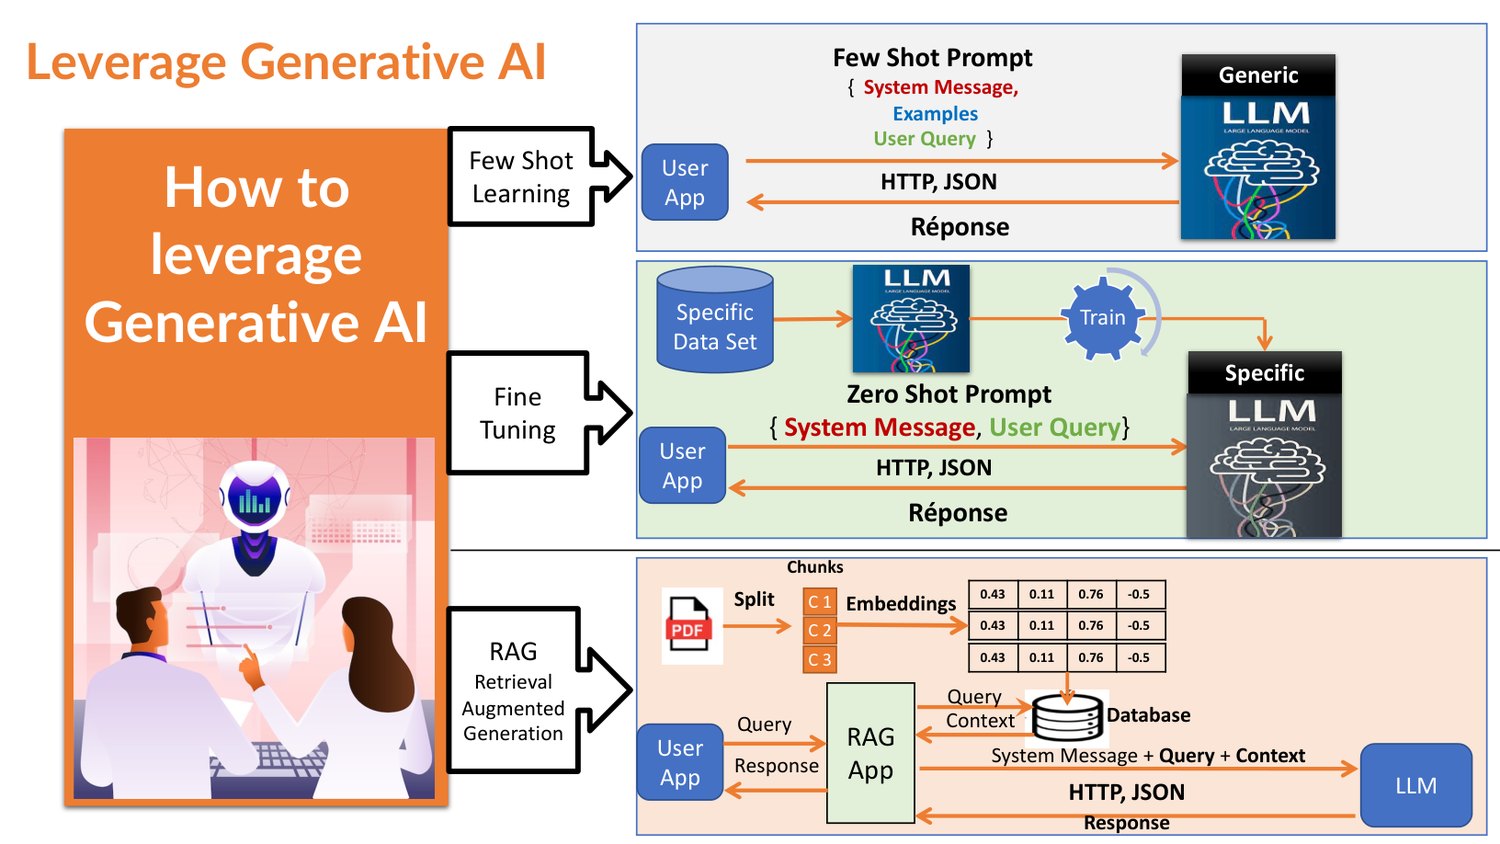
Les supports Youssfi détaillent les étapes classiques : ingestion des documents, découpage en chunks, embeddings, stockage dans une base vectorielle, recherche sémantique puis augmentation du prompt avec les contenus retrouvés.
Ce que la formation couvre
- Chunking : comment découper les documents sans perdre le sens.
- Embeddings et recherche sémantique.
- Vector stores et métadonnées.
- Prompt augmenté, citations et traçabilité.
- Évaluation de la pertinence et de la fidélité aux sources.
RAG multimodal
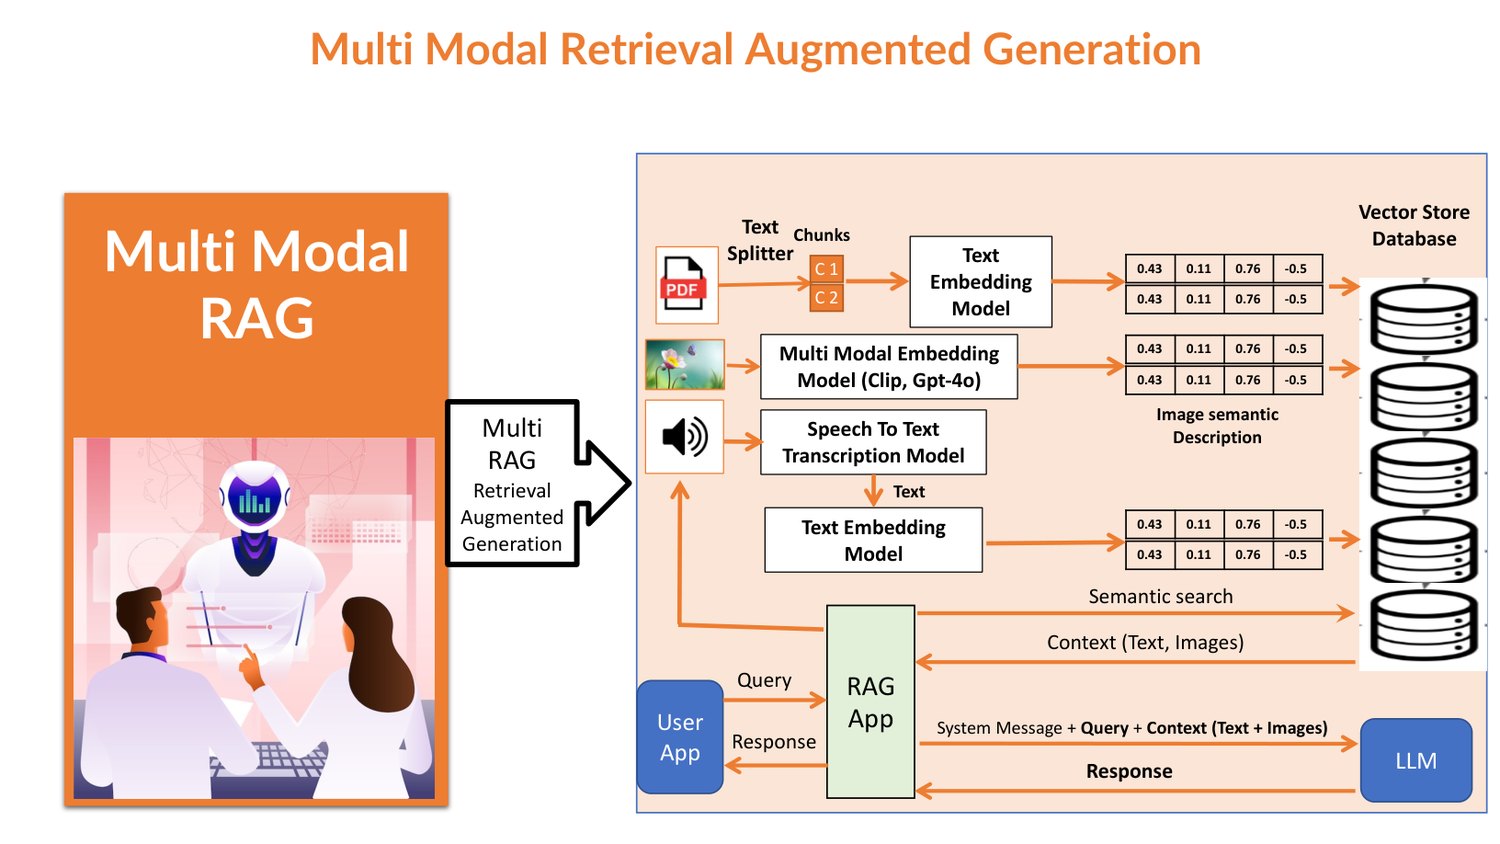
Lorsque les sources contiennent des tableaux, des images ou de l’audio, l’architecture peut combiner plusieurs méthodes d’extraction et d’embedding. Le support Youssfi montre notamment une chaîne multimodale où texte, image et transcription alimentent la recherche contextuelle.
Cas d’usage
- Assistant interne sur procédures et documentation qualité.
- Recherche dans contrats, appels d’offres ou documentation produit.
- FAQ interne avec réponses sourcées.
- Assistance support à partir d’une base de connaissances.
Le contenu, les exercices et les cas pratiques peuvent être adaptés à vos outils, vos documents, votre niveau et vos enjeux métier.
Faire le diagnostic IA